Wichtigste Ergebnisse
- 70,2 % des KI-Markenwissens ist nicht zurückverfolgbar: die mit Abstand größte Kategorie
- GPT-5.2-Sentiment von 0,83 gegenüber Gemini-Sentiment von 0,32 für dieselben Marken: Die Modelle erzählen unterschiedliche Geschichten
- Nur 2,8 % der KI-Ausgaben sind stabil, während 93,8 % über wiederholte Prompts hinweg variabel sind
- Unternehmenseigene Inhalte (14,7 %) sind die Nummer 1 unter den identifizierbaren Quellen des KI-Markenwissens
- Börsennotierte im Vergleich zu privaten Unternehmen: statistisch identische KI-Behandlung über alle Metriken hinweg
Ihre Marke hat einen KI-Ruf. Das Problem: Er ändert sich je nachdem, welche KI Ihr Kunde nutzt, wann er fragt und wie er die Frage formuliert. Wir haben die größte branchenübergreifende Studie zur KI-Reputations-Sourcing durchgeführt. Hier ist das, was jeder Marketingfachmann wissen muss.
Warum diese Studie wichtig ist
Jedes Mal, wenn ein Käufer ChatGPT, Gemini oder Perplexity nach Ihrer Branche fragt, konstruieren diese KI-Plattformen eine Erzählung über Ihre Marke in Echtzeit. Diese Erzählung ist Ihr KI-Ruf. Anders als bei traditioneller Medienberichterstattung können Sie ihn nicht sehen, seine Quellen nicht nachvollziehen und nicht vorhersagen, was er als Nächstes sagen wird.
Wir wollten vier Fragen beantworten: Woher bezieht KI ihr Markenwissen? Wie konsistent ist es? Ändert sich die Antwort nach Branche? Und haben börsennotierte Unternehmen einen Vorteil?
Die Ergebnisse sind unbequem für alle, die denken, dass KI-Sichtbarkeit ein einfaches Problem ist.
Was wir getestet haben
Wir untersuchten 24 echte Unternehmen über 8 Branchen: E-Commerce, Healthcare-Technologie, Logistik, Unternehmensberatung, HR-Tech, Web-Hosting, Marketing-Technologie und FinTech. Die Hälfte waren börsennotiert, die Hälfte privat. Die Unternehmen reichten von Fortune-500-Firmen bis zu Startups.
Wir haben 1.296 Prompts über GPT-5.2 und Gemini 3 Flash sowie 72 verankerte Messungen über Perplexity durchgeführt. Jeder Stabilitätsprompt wurde fünfmal pro Marke wiederholt, um die Konsistenz zu messen. Insgesamt analysierten wir 1.311 Antworten und kodierten 3.041 Quellenattributionen manuell.
Dies ist kein Blog-Beitrag mit Anekdoten. Dies ist eine begutachtete Studie, die in Springers Discover Artificial Intelligence veröffentlicht wurde.
Erkenntnis 1: 70% von dem, was KI über Ihre Marke „weiß", kann nicht nachvollzogen werden
Wir klassifizierten jede Quellenattribution, die KI bei der Diskussion von Marken vornahm. Die einzeln größte Kategorie: „Sonstige/Nicht zuordenbar" mit 70,2%. KI weiß Dinge über Ihre Marke, aber wir können nicht genau feststellen, woher diese Informationen stammen.
Die Quellen, die wir nachvollziehen konnten:
| Quellentyp | Anteil aller Zitierungen |
|---|---|
| Unternehmenseigene Inhalte | 14,7% |
| Tier-1-Nachrichtenmedien | 5,7% |
| Bewertungsplattformen | 4,6% |
| Branchennachrichten | 1,8% |
| Wikipedia | 1,5% |
| Finanz-/Behördliche Quellen | 0,6% |
| Soziale Medien | 0,5% |
| 0,4% | |
| Behördenquellen | 0,1% |
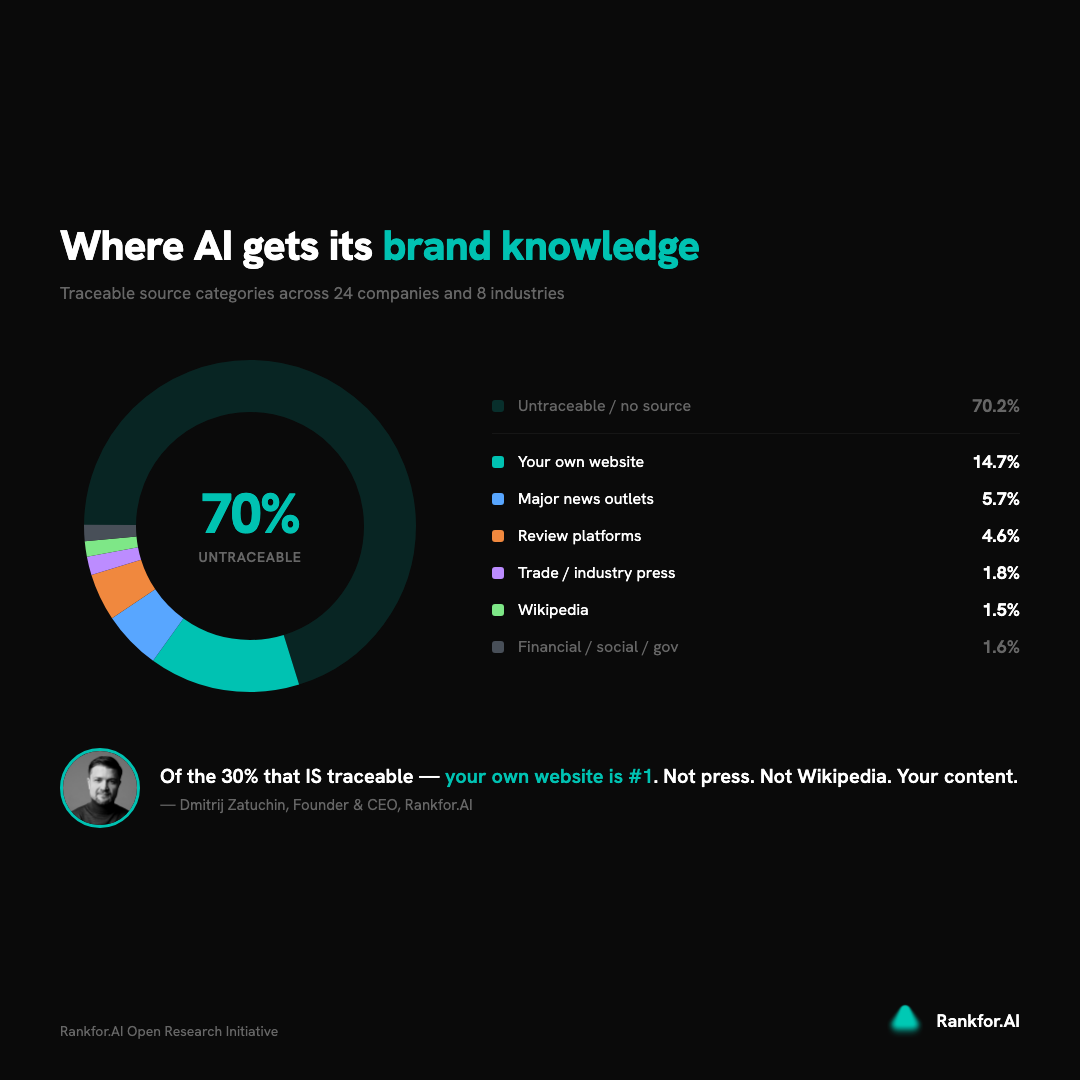
Was das für Sie bedeutet: Ihre eigenen Website-Inhalte sind die einzeln größte identifizierbare Quelle des KI-Markenwissens. Traditionelle PR (Tier-1-Medien) ist die zweite. Alles andere ist marginal. Aber die 70%, die Sie nicht über einen direkten Kanal beeinflussen können, ist die strukturelle Herausforderung, über die niemand spricht.
Erkenntnis 2: KI-Modelle erzählen völlig unterschiedliche Geschichten über Ihre Marke
Wir verglichen, wie GPT-5.2 und Gemini 3 Flash dieselben Marken wahrnehmen. Der Unterschied ist dramatisch.
GPT-5.2 lieferte einen durchschnittlichen Sentimentwert von 0,83 (auf einer Skala von -1 bis +1). Das ist überwiegend positiv. Tatsächlich waren 96,4% der GPT-Antworten über Marken positiv.
Gemini 3 Flash lieferte einen Durchschnitts-Sentiment von 0,32. Nur 51,5% seiner Antworten waren positiv.
Die Korrelation zwischen den Sentimentwerten beider Modelle? r = 0,37 – schwach und statistisch nicht signifikant. Die Modelle verwenden nicht nur unterschiedliche Skalen. Sie gewichten völlig unterschiedliche Aspekte des Rufs.
Was das für Sie bedeutet: Wenn Sie Ihre KI-Präsenz nur auf ChatGPT überprüfen, sehen Sie ein künstlich rosiges Bild. Ihre Kunden nutzen mehrere KI-Plattformen. Jede erzählt eine andere Geschichte über Sie.
Erkenntnis 3: Fragen Sie dieselbe KI zweimal und Sie bekommen unterschiedliche Antworten
Wir wiederholten denselben Prompt fünfmal für jede Marke auf jedem Modell. Der durchschnittliche Konsistenzwert über alle Unternehmen: 0,54 Kosinus-Ähnlichkeit.
Um das in Perspektive zu setzen: Nur 2,8% aller Unternehmens-Modell-Prompt-Kombinationen überschritten die 0,85-Schwelle, die wir als „stabil" definierten. Unterdessen fielen 93,8% unter 0,70, was wir als „variabel" klassifizierten.
GPT-5.2 war etwas konsistenter (0,57) als Gemini 3 Flash (0,51), aber kein Modell gibt zuverlässig die gleiche Antwort.
Was das für Sie bedeutet: Es gibt keinen festen „KI-Ruf". Jedes Mal, wenn jemand nach Ihrer Marke fragt, konstruiert KI eine etwas andere Erzählung. Eine Audit mit einem einzelnen Prompt erfasst eine Annäherung, nicht die Wahrheit. Sie brauchen wiederholte Messungen, um Ihre tatsächliche KI-Präsenz zu verstehen.
Erkenntnis 4: Ihre Branche bestimmt, welche Quellen KI nutzt
Wir fanden einen statistisch signifikanten Zusammenhang zwischen Branchensektor und Quellenverteilung (Chi-Quadrat = 143,28, p < 0,001). Die Effektgröße ist klein (Cramers V = 0,08), aber die Muster sind real und handhabbar.
Unternehmensberatungen haben die reichhaltigste identifizierbare Quellenmischung: 30,8% ihres KI-Rufs kommt aus Unternehmensinhalten plus Tier-1-Nachrichten zusammen. McKinsey erhält 8% seiner verfolgbaren Zitierungen aus Outlets wie Bloomberg und Financial Times.
Marketing-Technologie-Unternehmen sind mit der höchsten Quellen-Undurchsichtigkeit konfrontiert: 81,3% ihres KI-Rufs ist nicht zuordenbar. Wenn Sie im B2B-Tech-Bereich tätig sind, gehen Sie davon aus, dass das Meiste, das KI über Sie weiß, in seinen Trainingsdaten ohne klare Herkunft enthalten ist.
HR-Tech-Marken verlassen sich stark auf Bewertungsplattformen: 9,6% der identifizierbaren Quellen stammen von G2, Capterra und ähnlichen Seiten – das Höchste aller Sektoren.
Was das für Sie bedeutet: Ihre KI-Inhaltsstrategie muss mit den Quellenmustern übereinstimmen, die KI tatsächlich in Ihrer Branche nutzt. Eine Unternehmensberatung sollte in Gedankenführerschaft und Medienbeziehungen investieren. Ein HR-Tech-Unternehmen sollte in Bewertungsplattform-Präsenz investieren. Ein generisches Playbook wird nicht funktionieren.
Erkenntnis 5: Börsennotierung gibt Ihnen null Vorteil
Wir verglichen 12 börsennotierte Unternehmen mit 12 privaten Unternehmen über alle gemessenen Metriken. Die Ergebnisse: statistisch identisch.
- Konsistenz: Börsennotiert 0,54 vs. Privat 0,54 (d = 0,03, vernachlässigbar)
- Sentiment: Börsennotiert 73,9% positiv vs. Privat 74,5% positiv
- Quellenvielfalt: Kein signifikanter Unterschied (Shannon-Entropie: 1,43 vs. 1,37)
- Zitierungsreichtum: Private Unternehmen erhielten tatsächlich etwas mehr Attributionen pro Unternehmen (130,0 vs. 123,4)
- Finanz-/Behördliche Quellen: Weniger als 1% für beide Gruppen
SEC-Anmeldungen, Bloomberg-Berichterstattung, Crunchbase-Profile – nichts davon gibt börsennotierten Unternehmen einen messbaren Vorteil bei der KI-Wahrnehmung.
Was das für Sie bedeutet: Wenn Sie ein privates Unternehmen oder ein Startup sind, sind Sie nicht strukturell benachteiligt. KI behandelt ein Startup genauso wie ein Fortune-500-Unternehmen. Das Spielfeld ist eben. Die Frage ist nicht die Größe Ihres Unternehmens – es ist die Frage, ob Ihre Inhalte für KI-Verständnis strukturiert sind.
Die Ausnahme des verankerten Modus
Es gibt einen hellen Fleck in all dem. Wenn KI-Modelle Retrieval-Augmented-Generation nutzen (der Modus, in dem sie aktiv das Web durchsuchen, bevor sie antworten), wird die Quellenattribution transparent. Wir testeten dies mit Perplexity, das URL-genaue Zitierungen bereitstellt.
Im verankerten Modus schrumpft die Kategorie „Nicht zuordenbar" dramatisch. Sie können genau sehen, welche Seiten KI herangezogen hat, die Genauigkeit überprüfen und entsprechend optimieren.
Was das für Sie bedeutet: Da mehr KI-Plattformen retrieval-augmented Modi einführen (wie Googles KI-Overviews oder Perplexitys Zitierungen), wird sich das Quellen-Opazitätsproblem verringern. Aber derzeit erfolgt die Mehrheit der KI-Gespräche über Marken im parametrischen Modus – wo 70% des Wissens keine nachverfolgbare Herkunft haben.
Was ab Montag zu tun ist
Die Forschung weist auf drei umsetzbare Prioritäten hin:
1. Prüfen Sie Ihre KI-Präsenz über mehrere Modelle
Fragen Sie nicht nur ChatGPT nach Ihrer Marke. Fragen Sie Gemini. Fragen Sie Perplexity. Bei einem Sentimentunterschied von 0,51 Punkten zwischen Modellen und nur 2,8% stabilen Ausgaben brauchen Sie einen Multi-Modell-, wiederholten-Messung-Ansatz, um Ihren tatsächlichen KI-Ruf zu verstehen.
2. Investieren Sie in die Quellen, die tatsächlich wichtig sind
70% des KI-Wissens ist in Trainingsdaten eingebacken und nicht nachverfolgbar. Von den 30%, die Sie beeinflussen können: Ihre eigenen Website-Inhalte (14,7%) und Tier-1-Medienberichterstattung (5,7%) sind die beiden größten. Bewertungsplattformen sind für spezifische Branchen wichtig (besonders HR-Tech mit 9,6%). Soziale Medien und LinkedIn machen zusammen weniger als 1% aus.
Prioritäten: Unternehmenseigene Inhalte zuerst, verdiente Medien zweites, branchenspezifische Quellen dritte.
3. Bauen Sie eine Überwachungsgewohnheit auf
Der KI-Ruf ist nicht stabil. Er ändert sich mit jeder Abfrage, jedem Modell-Update, jedem neuen Trainingsdatensatz. Sie würden nicht einmal Ihre Google-Rankings überprüfen und vergessen. Monatliche KI-Sichtbarkeitsüberwachung ist das Minimum. Vierteljährliche umfassende Audits über Modelle sind der Standard.
Studienbeschreibungen
- Stichprobe: 24 Unternehmen, 8 Branchen, 12 börsennotiert + 12 privat
- Prompts: 1.296 verabreicht, 1.311 analysierbare Antworten
- Modelle: GPT-5.2 (OpenAI), Gemini 3 Flash (Google), Perplexity (verderbt Modus)
- Quellenattributionen: 3.041 von zwei unabhängigen trainierten Kodierern kodiert
- Stabilitätsiterationen: 5 Wiederholungen pro Prompt pro Marke pro Modell
- Veröffentlichung: Springer Discover Artificial Intelligence (begutachtet)
- Datenerfassung: 20. Februar 2026
Die Kernaussage
KI baut einen Ruf für Ihre Marke auf, unabhängig davon, ob Sie ihn verwalten oder nicht. Die Frage ist, ob Sie verstehen, woher dieser Ruf kommt (meistens nicht nachverfolgbar), wie stabil er ist (nicht sehr), und wie unterschiedlich er über Plattformen hinweg aussieht (dramatisch unterschiedlich).
Die Marken, die im KI-Zeitalter Empfehlungsanteile gewinnen, werden nicht diejenigen mit den größten Budgets oder den längsten Erfolgsbillen sein. Sie werden diejenigen sein, die verstehen, wie KI über sie nachdenkt – und ihre Inhalte entsprechend strukturieren.
Nutzer fragen auch
Weiterlesen
Ihr KI-Sichtbarkeitsbericht misst Rauschen
Diese Studie untersucht die Antwort-Variabilität und die Konsistenz von Markennennungen bei drei führenden LLMs: Google Gemini 3 Flash, OpenAI GPT-5.2 und xAI Grok-4-1. Auf Basis von insgesamt 239 Stichproben bei drei Prompt-Variationen (Ehemann, Ehefrau, 2025) haben wir die Häufigkeit von Markennennungen, die Antwortkonsistenz und die modellübergreifende Übereinstimmung gemessen.
Only 1 in 6 Brands Has Strong AI Visibility: Corporate Visibility Pattern Analysis
Analysis of 195 AI queries across 6 corporate brands reveals three visibility patterns: Invisible (PGE, Polpharma), Brand-Dependent (TotalEnergies, Holcim), Topic-Locked (Orlen). Only 1 in 6 has strong AI presence.
Der Stand der AI Visibility: Warum Marken die Kontrolle in AI-Antworten verlieren
Die Suche gibt es weiterhin, doch Entscheidungen fallen inzwischen an anderer Stelle. Traditionelles SEO ging davon aus, dass man entdeckt wird, wenn man gut rankt. AI funktioniert so nicht. Dieser Fachbeitrag definiert, warum AI Visibility wichtig ist, und stellt ihre vier Dimensionen vor: Präsenz, Relevanz, Nützlichkeit und Vertrauen.
AI-Sichtbarkeitsklassifizierung verstehen: Die 8 Zustände, die definieren, wie KI Ihre Marke sieht
Die Sichtbarkeit Ihrer Marke für KI ist vielschichtig und geht weit über einfache „Sichtbarkeit“ oder „Unsichtbarkeit“ hinaus. Es gibt 8 unterschiedliche Zustände (von Unsichtbar bis Kategorieführer), und jeder Zustand erfordert eine eigene Strategie. Dieser Artikel erklärt das Klassifizierungssystem hinter dem AI Visibility Score und zeigt, wie metrische Muster Ihre strategische Diagnose bestimmen.
Die „Best of“-Falle: Warum selbstwerbende Listicles bei Google verlieren und bei ChatGPT gewinnen
Drei Signale in einer Woche: Google straft selbstwerbende Listicles ab (SaaS-Marken verlieren 34-49 % ihrer Sichtbarkeit) und senkt sein Crawl-Limit um 86,7 %, während Ahrefs herausfand, dass 44 % der ChatGPT-Zitate aus genau diesen Listicles stammen. Google schrumpft, KI wächst. Enthält einen Leitfaden für ein 5-Minuten-Markenaudit und eine geteilte Strategie für den Umgang mit beiden Entdeckungssystemen.
Kindle: 100 % der Anfragen zu Frauen. 0 % der Anfragen zu Männern. Dieselbe KI.
Diese Studie erweitert die promptübergreifende LLM-Markenkonsistenzanalyse durch die Einführung eines geschlechtsneutralen „Partner“-Prompts, um die Effekte von Geschlechtsbias zu isolieren. Durch den Vergleich von vier Prompt-Varianten bei insgesamt 299 Stichproben liefern wir klare Beweise für geschlechtsspezifische Verzerrungen bei Markenempfehlungen in LLMs. Wichtigster Befund: Kindle erschien in 100 % der Durchläufe für Ehefrau und Partner, aber in 0 % der Durchläufe für Ehemann.
BeVisible Club
Erhalten Sie Forschungsergebnisse wie diese noch vor der Veröffentlichung.
Neue Studien zur KI-Sichtbarkeit, Ranking-Muster und Source-Stack-Daten eine Woche vor Veröffentlichung direkt in Ihr Postfach.
BeVisible Club beitretenMöchten Sie wissen, wie die KI Ihre Marke sieht?
Rankfor.AI misst die KI-Sichtbarkeit Ihrer Marke auf allen wichtigen Plattformen und bietet konkrete Handlungsempfehlungen.
Über den Autor
Gründer
Dmitrij Żatuchin ist der Gründer von Rankfor.AI. Als Informatiker mit einer Promotion in semantischen Webtechnologien schließt er die Lücke zwischen der Art und Weise, wie KI über Marken schlussfolgert, und wie Marken verstanden werden wollen. Mit über zwei Jahrzehnten Erfahrung in der Softwarearchitektur und akademischen Funktionen an der Estonian Business School baut Dmitrij die Messinfrastruktur auf, die Marken für den Übergang von der Optimierung für Suchmaschinen zur Sichtbarkeit in Reasoning-Engines benötigen.