Key Findings
- 70.2% of AI brand knowledge is untraceable -- the largest category by far
- GPT-5.2 sentiment 0.83 vs Gemini 0.32 for the same brands -- models tell different stories
- Only 2.8% of AI outputs are stable -- 93.8% are variable across repeated prompts
- Company-owned content (14.7%) is the #1 identifiable source of AI brand knowledge
- Listed vs private companies: statistically identical AI treatment across all metrics
Brändilläsi on tekoälymaine. Ongelma: se muuttuu sen mukaan, mitä tekoälyä asiakkaasi käyttää, milloin he kysyvät ja miten he muotoilevat kysymyksen. Toteutimme laajimman monitoimialaisen tutkimuksen tekoälymaineen lähteistä tähän mennessä. Tässä mitä jokaisen markkinoijan täytyy tietää.
Miksi tämä tutkimus on tärkeä
Joka kerta kun ostaja kysyy ChatGPT:ltä, Geminiltä tai Perplexityltä toimialastasi, nämä tekoälyalustat rakentavat kertomuksen brändistäsi reaaliajassa. Tuo kertomus on tekoälymaineesi. Toisin kuin perinteinen mediajulkisuus, et voi nähdä sitä, jäljittää sen lähteitä tai ennustaa mitä se sanoo seuraavaksi.
Asetimme tavoitteeksemme vastata neljään kysymykseen: Mistä tekoäly saa brändiosaamisen? Kuinka johdonmukaista se on? Vaikuttaako toimialasi vastaukseen? Ja onko julkisesti noteeratuilla yrityksillä etulyöntiasema?
Tulokset ovat epämukavia kaikille, jotka ajattelevat tekoälynäkyvyyden olevan yksinkertainen ongelma.
Mitä testasimme
Tutkimme 24 todellista yritystä 8 toimialalta: Verkkokauppa, Terveysteknologia, Logistiikka, Konsultointi, HR-teknologia, Web-hosting, Markkinointiteknologia ja FinTech. Puolet oli julkisesti noteerattuja, puolet yksityisiä. Yritykset vaihtelivat Fortune 500 -yrityksistä startup-yrityksiin.
Toteutimme 1 296 kehotetta GPT-5.2:n ja Gemini 3 Flash:n välillä sekä 72 perusteltua kyselyä Perplexityn kautta. Jokainen vakauskehote toistettiin viisi kertaa per brändi johdonmukaisuuden mittaamiseksi. Kaiken kaikkiaan analysoimme 1 311 vastausta ja koodasimme 3 041 lähdeviittausta käsin.
Tämä ei ole blogikirjoitus anekdootteineen. Tämä on vertaisarvioitu tutkimus, joka on julkaistu Springerin Discover Artificial Intelligence -lehdessä.
Havainto 1: 70% siitä, mitä tekoäly "tietää" brändistäsi, ei voi jäljittää
Luokittelimme jokaisen lähdeviittauksen, jonka tekoäly teki käsitellessään brändejä. Suurin yksittäinen kategoria: "Muu / Jäljittämätön" 70,2%. Tekoäly tietää asioita brändistäsi, mutta emme voi täsmällisesti osoittaa, mistä tuo tieto on peräisin.
Lähteet, jotka pystyimme jäljittämään:
| Lähdetyyppi | Osuus kaikista viittauksista |
|---|---|
| Yrityksen oma sisältö | 14,7% |
| Tier-1 uutismedia | 5,7% |
| Arvosteluportaalit | 4,6% |
| Toimiala-/sektorimedia | 1,8% |
| Wikipedia | 1,5% |
| Talous-/sääntelytiedot | 0,6% |
| Sosiaalinen media | 0,5% |
| 0,4% | |
| Viranomaislähteet | 0,1% |
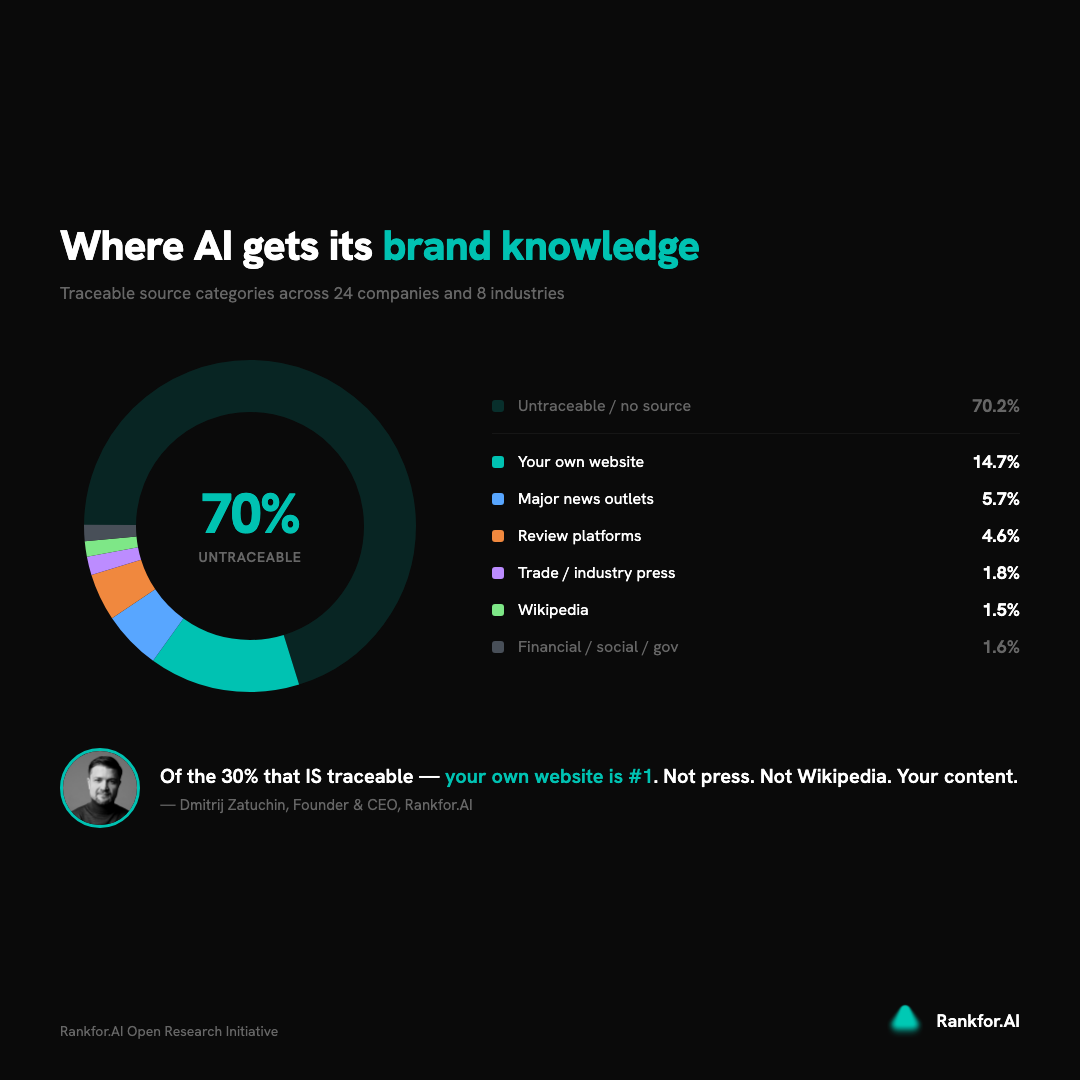
Mitä tämä tarkoittaa sinulle: Oman verkkosivustosi sisältö on suurin tunnistettavissa oleva tekoälyn brändiosaamisen lähde. Perinteinen PR (tier-1 media) on toisella sijalla. Kaikki muu on marginaalista. Mutta 70%, johon et voi vaikuttaa millään suoralla kanavalla, on rakenteellinen haaste, josta kukaan ei puhu.
Havainto 2: Tekoälymallit kertovat täysin erilaisia tarinoita brändistäsi
Vertailimme, miten GPT-5.2 ja Gemini 3 Flash havaitsevat samat brändit. Kuilu on dramaattinen.
GPT-5.2 tuotti keskimääräisen sentimenttipisteen 0,83 (asteikolla -1 - +1). Se on ylivoimaisesti positiivinen. Itse asiassa 96,4% GPT:n vastauksista brändeistä oli positiivisia.
Gemini 3 Flash tuotti keskimääräisen sentimentin 0,32. Vain 51,5% sen vastauksista oli positiivisia.
Kahden mallin sentimenttipisteiden välinen korrelaatio? r = 0,37 -- heikko eikä tilastollisesti merkitsevä. Mallit eivät vain käytä erilaisia asteikkoja. Ne painottavat maineen täysin erilaisia näkökohtia.
Mitä tämä tarkoittaa sinulle: Jos tarkistat tekoälynäkyvyytesi vain ChatGPT:ssä, näet keinotekoisen ruusuisen kuvan. Asiakkaasi käyttävät useita tekoälyalustoja. Jokainen kertoo sinusta erilaisen tarinan.
Havainto 3: Kysy samalta tekoälyltä kahdesti ja saat erilaisia vastauksia
Toistimme saman kehotteen viisi kertaa jokaiselle brändille jokaisessa mallissa. Keskimääräinen johdonmukaisuuspiste kaikissa yrityksissä: 0,54 kosiniyhtäläisyyttä.
Asiayhteydessä: vain 2,8% kaikista yritys-malli-kehote-yhdistelmistä ylitti 0,85 kynnysarvon, jonka määrittelimme "vakaaksi". Samaan aikaan 93,8% jäi alle 0,70, jonka luokittelimme "muuttuvaksi".
GPT-5.2 oli hieman johdonmukaisempi (0,57) kuin Gemini 3 Flash (0,51), mutta kumpikaan malli ei anna samaa vastausta luotettavasti.
Mitä tämä tarkoittaa sinulle: Ei ole olemassa kiinteää "tekoälymainetta". Joka kerta kun joku kysyy brändistäsi, tekoäly rakentaa hieman erilaisen kertomuksen. Yksittäisen kehotteen tarkistus tavoittaa likiarvon, ei totuutta. Tarvitset toistuvia mittauksia ymmärtääksesi todellisen tekoälyläsnäolosi.
Havainto 4: Toimialasi määrittää, mitä lähteitä tekoäly käyttää
Löysimme tilastollisesti merkitsevän suhteen toimialasektorin ja lähdejakauman välillä (chi-neliö = 143,28, p < 0,001). Vaikutuskoko on pieni (Cramerin V = 0,08), mutta kuviot ovat todellisia ja toteutuskelpoisia.
Konsulttiyritykset saavat rikkaimman tunnistettavissa olevan lähdesekoituksen: 30,8% niiden tekoälymaineesta tulee yrityssisällöstä ja tier-1 uutisista yhdessä. McKinsey saa 8% jäljitettävissä olevista viittauksistaan julkaisuista kuten Bloomberg ja Financial Times.
Markkinointiteknologiayritykset kohtaavat suurimman lähdeläpinäkymättömyyden: 81,3% niiden tekoälymaineesta on jäljittämätöntä. Jos olet B2B-teknologiassa, oleta että suurin osa siitä, mitä tekoäly tietää sinusta, on valmennusdatassa ilman selvää alkuperää.
HR-teknologiabrändit nojaavat vahvasti arvosteluportaaleihin: 9,6% tunnistettavissa olevista lähteistä tulee G2:sta, Capterrasta ja vastaavista sivustoista -- korkein kaikista sektoreista.
Mitä tämä tarkoittaa sinulle: Tekoälysisältöstrategiasi täytyy vastata lähdekaavoja, joita tekoäly tosiasiallisesti käyttää toimialallasi. Konsulttiyrityksen tulisi investoida ajatusjohtajuuteen ja mediasuhteisiin. HR-teknologiayrityksen tulisi investoida arvosteluportaaliläsnäoloon. Geneerinen käsikirja ei toimi.
Havainto 5: Julkinen pörssilistauspaikka ei anna sinulle mitään etua
Vertailimme 12 listattua yritystä 12 yksityiseen yritykseen kaikissa mittaamassamme mittareissa. Tulokset: tilastollisesti identtiset.
- Johdonmukaisuus: Listatut 0,54 vs. Yksityiset 0,54 (d = 0,03, vähäinen)
- Sentimentti: Listatut 73,9% positiivisia vs. Yksityiset 74,5% positiivisia
- Lähteiden monimuotoisuus: Ei merkitsevää eroa (Shannonin entropia: 1,43 vs. 1,37)
- Viittausrikkaus: Yksityiset yritykset itse asiassa saivat hieman enemmän viittauksia per yritys (130,0 vs. 123,4)
- Talous-/sääntelylähteet: Alle 1% molemmille ryhmille
SEC-ilmoitukset, Bloomberg-julkisuus, Crunchbase-profiilit -- mikään niistä ei anna listatuille yrityksille mitattavaa etua siinä, miten tekoäly havaitsee ne.
Mitä tämä tarkoittaa sinulle: Jos olet yksityinen yritys tai startup, et ole rakenteellisesti heikommassa asemassa. Tekoäly kohtelee startupia samalla tavalla kuin Fortune 500 -yritystä. Pelikenttä on tasainen. Kysymys ei ole yrityksesi koosta -- vaan siitä, onko sisältösi rakennettu tekoälyn ymmärtämistä varten.
Perusteltu tila -poikkeus
On yksi valoisapiste kaikessa tässä. Kun tekoälymallit käyttävät retrieval-augmented generation -tilaa (tila, jossa ne aktiivisesti etsivät verkosta ennen vastaamista), lähdeviittaus muuttuu läpinäkyväksi. Testasimme tätä Perplexityllä, joka tarjoaa URL-tason viittaukset.
Perustellussa tilassa "jäljittämätön" kategoria kutistuu dramaattisesti. Voit nähdä tarkalleen, mistä sivuista tekoäly haki, vahvistaa tarkkuuden ja optimoida vastaavasti.
Mitä tämä tarkoittaa sinulle: Kun yhä useammat tekoälyalustat ottavat käyttöön retrieval-augmented -tilat (kuten Googlen AI Overviews tai Perplexityn viittaukset), lähdeläpinäkymättömyysongelma vähenee. Mutta toistaiseksi suurin osa tekoälykeskusteluista brändeistä tapahtuu parametrisessa tilassa -- jossa 70% tiedosta ei ole jäljitettävissä olevaa alkuperää.
Mitä tehdä maanantaista alkaen
Tutkimus osoittaa kolme toteutuskelpoista prioriteettia:
1. Tarkista tekoälyläsnäolosi useilla malleilla
Älä vain kysy ChatGPT:ltä brändistäsi. Kysy Geminiltä. Kysy Perplexityltä. 0,51 pisteen sentimenttikuilulla mallien välillä ja vain 2,8% tulosteista ollessa vakaita, tarvitset monisuunnitelman, toistuvan mittauksen lähestymistavan ymmärtääksesi todellisen tekoälymaineesi.
2. Investoi lähteisiin, jotka todella merkitsevät
70% tekoälytiedosta on valmennusdatassa eikä jäljitettävissä. Siitä 30%:sta, johon voit vaikuttaa: oman verkkosivustosi sisältö (14,7%) ja tier-1 mediajulkisuus (5,7%) ovat kaksi tärkeintä. Arvosteluportaalit ovat tärkeitä tietyillä toimialoilla (erityisesti HR-teknologia 9,6%). Sosiaalinen media ja LinkedIn yhdessä muodostavat alle 1%.
Priorisoi: yrityksen oma sisältö ensin, ansaittu media toiseksi, toimialakohtaiset lähteet kolmanneksi.
3. Rakenna seurantatapa
Tekoälymaine ei ole vakaa. Se muuttuu jokaisella kyselyllä, jokaisella mallipäivityksellä, jokaisella uudella valmennusdatan palalla. Et tarkistaisi Google-sijoituksiasi kerran ja unohtaisi asiaa. Kuukausittainen tekoälynäkyvyyden seuranta on minimi. Neljännesvuosittaiset kattavat tarkistukset mallien yli ovat standardi.
Tutkimuksen yksityiskohdat
- Otos: 24 yritystä, 8 toimialaa, 12 julkisesti listattua + 12 yksityistä
- Kehotteet: 1 296 toteutettua, 1 311 analysoitavissa olevaa vastausta
- Mallit: GPT-5.2 (OpenAI), Gemini 3 Flash (Google), Perplexity (perusteltu tila)
- Lähdeviittaukset: 3 041 koodattua kahden itsenäisen koulutetun koodaajan toimesta
- Vakausiteraatiot: 5 toistoa per kehote per brändi per malli
- Julkaisu: Springer Discover Artificial Intelligence (vertaisarvioitu)
- Tiedonkeruu: 20. helmikuuta 2026
Lopputulos
Tekoäly rakentaa mainetta brändillesi hoidatpa sitä tai et. Kysymys on, ymmärrätkö mistä tuo maine tulee (enimmäkseen jäljittämätön), kuinka vakaa se on (ei kovin), ja kuinka erilainen se näyttää eri alustoilla (dramaattisesti erilainen).
Brändit, jotka voittavat suositusosuuden tekoälyaikakaudella, eivät ole niitä, joilla on suurimmat budjetit tai pisimmät historia. Ne ovat niitä, jotka ymmärtävät, miten tekoäly päättelee niistä -- ja rakentavat sisältönsä vastaavasti.
People Also Ask
Continue Reading
Cross-Model Response Stability Analysis: A Comparative Study of Brand Mention Consistency in Large Language Models
This study investigates response variability and brand mention consistency across three leading LLMs: Google Gemini 3 Flash, OpenAI GPT-5.2, and xAI Grok-4-1. Using 239 total samples across three prompt variations (husband, wife, 2025), we measured brand mention frequency, response consistency, and cross-model agreement.
Only 1 in 6 Brands Has Strong AI Visibility: Corporate Visibility Pattern Analysis
Analysis of 195 AI queries across 6 corporate brands reveals three visibility patterns: Invisible (PGE, Polpharma), Brand-Dependent (TotalEnergies, Holcim), Topic-Locked (Orlen). Only 1 in 6 has strong AI presence.
The State of AI Visibility: Why Brands Are Losing Control Inside AI Answers
Search didn't disappear. It stopped being the place where decisions happen. Traditional SEO assumed that if you ranked well, you would be discovered. AI doesn't work that way. This thought leadership piece defines why AI visibility matters and introduces the four dimensions of AI visibility: Presence, Relevance, Usefulness, and Trust.
Understanding AI Visibility Classification: The 8 States That Define How AI Sees Your Brand
Your brand is not just "visible" or "invisible" to AI. There are 8 distinct states - from Invisible to Category Leader - and each one requires a different strategy. This article explains the classification system behind the AI Visibility Score and how metric patterns determine your strategic diagnosis.
The "Best Of" Trap: Why Self-Promotional Listicles Are Losing Google and Winning ChatGPT
Three signals in one week: Google penalized self-promotional listicles (SaaS brands losing 34-49% visibility), reduced crawl limits by 86.7%, while Ahrefs found 44% of ChatGPT citations come from those exact listicles. Google is shrinking, AI is expanding. Includes a 5-minute brand audit playbook and split strategy for navigating both discovery systems.
Four-Prompt Gender Bias Analysis: Isolating Gender Effects in LLM Brand Recommendations
This study extends cross-prompt LLM brand consistency analysis by introducing a gender-neutral "partner" prompt to isolate gender bias effects. Comparing four prompt variations across 299 total samples, we provide strong evidence of gender-based brand recommendation bias in LLMs. Critical finding: Kindle appeared in 100% of wife AND partner iterations but 0% of husband iterations.
BeVisible Club
Get research like this before we publish it.
New AI visibility studies, ranking patterns, and source-stack data delivered to your inbox a week before they go public.
Join BeVisible ClubWant to Know How AI Sees Your Brand?
Rankfor.AI measures your brand's AI visibility across all major platforms and provides actionable recommendations.
About the Author
Founder
Dmitrij Żatuchin is the founder of Rankfor.AI. A computer scientist with a PhD in semantic web technologies, he bridges the gap between how AI reasons about brands and how brands want to be understood. With over two decades of software architecture experience and academic roles at Estonian Business School, Dmitrij builds the measurement infrastructure brands need to transition from optimizing for search engines to becoming visible for reasoning engines.