Belangrijkste bevindingen
- 70,2% van de AI-merkkennis is niet te traceren: dit is met afstand de grootste categorie
- Het sentiment van GPT-5.2 is 0,83 vergeleken met 0,32 voor Gemini bij dezelfde merken: de modellen vertellen verschillende verhalen
- Slechts 2,8% van de AI-outputs is stabiel: 93,8% is variabel bij herhaalde prompts
- Bedrijfseigen content (14,7%) is de #1 identificeerbare bron van AI-merkkennis
- Beursgenoteerde versus private bedrijven: een statistisch identieke AI-behandeling over alle metrieken
Uw merk heeft een AI-reputatie. Het probleem: deze verandert afhankelijk van welke AI uw klant gebruikt, wanneer ze vragen en hoe ze de vraag formuleren. We voerden het grootste multi-industrie onderzoek naar AI-reputatiebronnen tot nu toe uit. Dit is wat elke marketeer moet weten.
Waarom Dit Onderzoek Belangrijk Is
Elke keer dat een koper ChatGPT, Gemini of Perplexity vraagt naar uw sector, bouwen deze AI-platforms in real-time een verhaal over uw merk. Dat verhaal is uw AI-reputatie. In tegenstelling tot traditionele mediaberichtgeving, kunt u het niet zien, de bronnen niet traceren of voorspellen wat het daarna zal zeggen.
We wilden vier vragen beantwoorden: Waar haalt AI zijn merkkennis vandaan? Hoe consistent is het? Verandert uw sector het antwoord? Hebben beursgenoteerde bedrijven een voordeel?
De resultaten zijn ongemakkelijk voor iedereen die denkt dat AI-zichtbaarheid een eenvoudig probleem is.
Wat We Hebben Getest
We bestudeerden 24 echte bedrijven in 8 sectoren: E-commerce, Gezondheidstechnologie, Logistiek, Consulting, HR Tech, Webhosting, Marketingtechnologie en FinTech. De helft was beursgenoteerd, de helft privaat. Bedrijven varieerden van Fortune 500-bedrijven tot startups.
We voerden 1,296 prompts uit via GPT-5.2 en Gemini 3 Flash, plus 72 gefundeerde-modus tests via Perplexity. Elke stabiliteitsprompt werd vijf keer per merk herhaald om consistentie te meten. In totaal analyseerden we 1,311 antwoorden en codeerden we handmatig 3,041 bronattributies.
Dit is geen blogpost met anekdotes. Dit is een peer-reviewed onderzoek gepubliceerd in Springer's Discover Artificial Intelligence journal.
Bevinding 1: 70% van Wat AI "Weet" over Uw Merk Kan Niet Worden Getraceerd
We classificeerden elke bronattributie die AI maakte bij het bespreken van merken. De grootste categorie: "Overig / Niet-toerekenbaar" met 70.2%. AI weet dingen over uw merk, maar we kunnen niet aanwijzen waar die informatie vandaan kwam.
De bronnen die we konden traceren:
| Brontype | Aandeel van Alle Citaties |
|---|---|
| Bedrijfseigen content | 14.7% |
| Tier-1 nieuwsmedia | 5.7% |
| Reviewplatforms | 4.6% |
| Handels-/sectornieuws | 1.8% |
| Wikipedia | 1.5% |
| Financieel/regelgevend | 0.6% |
| Social media | 0.5% |
| 0.4% | |
| Overheidsbronnen | 0.1% |
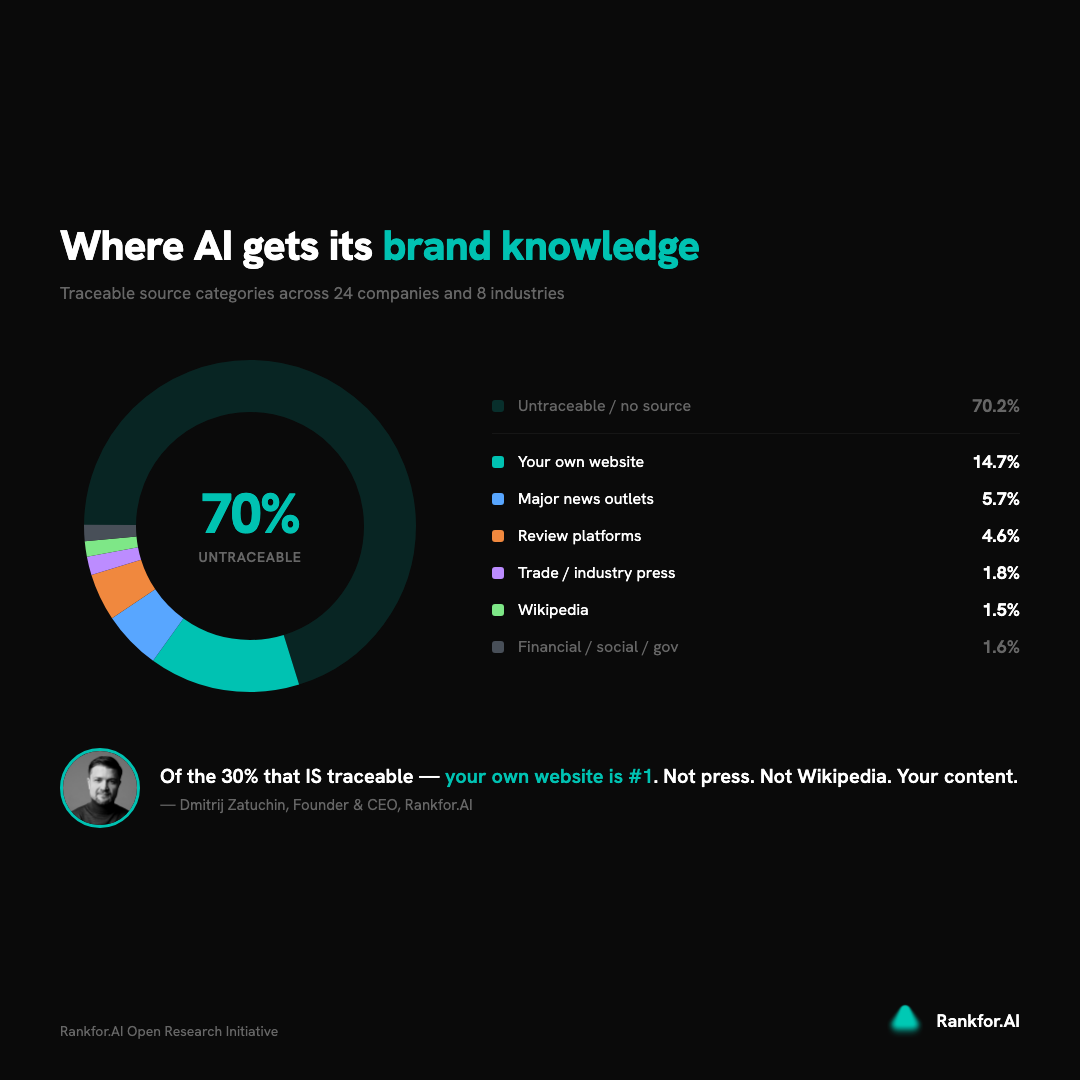
Wat dit voor u betekent: De content van uw eigen website is de grootste identificeerbare bron van AI-merkkennis. Traditionele PR (tier-1 media) is tweede. Alles andere is marginaal. Maar de 70% die u niet kunt beïnvloeden via enig direct kanaal is de structurele uitdaging waar niemand over praat.
Bevinding 2: AI-Modellen Vertellen Compleet Verschillende Verhalen over Uw Merk
We vergeleken hoe GPT-5.2 en Gemini 3 Flash dezelfde merken waarnemen. De kloof is dramatisch.
GPT-5.2 produceerde een gemiddelde sentimentscore van 0.83 (op een schaal van -1 tot +1). Dat is overweldigend positief. Feitelijk was 96.4% van GPT's antwoorden over merken positief.
Gemini 3 Flash produceerde een gemiddeld sentiment van 0.32. Slechts 51.5% van zijn antwoorden waren positief.
De correlatie tussen de sentimentscores van de twee modellen? r = 0.37 -- zwak en niet statistisch significant. De modellen gebruiken niet alleen verschillende schalen. Ze wegen volledig verschillende aspecten van reputatie.
Wat dit voor u betekent: Als u alleen uw AI-aanwezigheid op ChatGPT auditeert, ziet u een kunstmatig rooskleurig beeld. Uw klanten gebruiken meerdere AI-platforms. Elk vertelt een ander verhaal over u.
Bevinding 3: Vraag Dezelfde AI Twee Keer en U Krijgt Verschillende Antwoorden
We herhaalden dezelfde prompt vijf keer voor elk merk op elk model. De gemiddelde consistentiescore voor alle bedrijven: 0.54 cosinus-gelijkenis.
Om dat in perspectief te plaatsen: slechts 2.8% van alle bedrijf-model-prompt combinaties overschreed de drempel van 0.85 die we definieerden als "stabiel". Ondertussen viel 93.8% onder 0.70, wat we classificeerden als "variabel".
GPT-5.2 was iets consistenter (0.57) dan Gemini 3 Flash (0.51), maar geen enkel model geeft betrouwbaar hetzelfde antwoord.
Wat dit voor u betekent: Er bestaat geen vaste "AI-reputatie". Elke keer dat iemand naar uw merk vraagt, construeert AI een iets ander verhaal. Een audit met één prompt legt een benadering vast, niet de waarheid. U heeft herhaalde metingen nodig om uw werkelijke AI-aanwezigheid te begrijpen.
Bevinding 4: Uw Sector Bepaalt Welke Bronnen AI Gebruikt
We vonden een statistisch significante relatie tussen bedrijfssector en brondistributie (chi-kwadraat = 143.28, p < 0.001). De effectgrootte is klein (Cramer's V = 0.08), maar de patronen zijn reëel en bruikbaar.
Consultingfirma's krijgen de rijkste identificeerbare bronnenmix: 30.8% van hun AI-reputatie komt van bedrijfscontent plus tier-1 nieuws gecombineerd. McKinsey krijgt 8% van zijn traceerbare citaties van media als Bloomberg en Financial Times.
Marketingtechnologiebedrijven worden geconfronteerd met de hoogste bronondoorzichtigheid: 81.3% van hun AI-reputatie is niet toerekenbaar. Als u in B2B-tech zit, ga er dan van uit dat het meeste wat AI over u weet in zijn trainingsdata is gebakken zonder duidelijke oorsprong.
HR Tech-merken leunen zwaar op reviewplatforms: 9.6% van identificeerbare bronnen komt van G2, Capterra en vergelijkbare sites -- het hoogste van alle sectoren.
Wat dit voor u betekent: Uw AI-contentstrategie moet aansluiten bij de bronpatronen die AI daadwerkelijk gebruikt in uw sector. Een consultingfirma zou moeten investeren in thought leadership en mediarelaties. Een HR Tech-bedrijf zou moeten investeren in aanwezigheid op reviewplatforms. Een generiek draaiboek zal niet werken.
Bevinding 5: Beursgenoteerd Zijn Geeft U Geen Enkel Voordeel
We vergeleken 12 beursgenoteerde bedrijven met 12 privébedrijven op elke metriek die we maten. De resultaten: statistisch identiek.
- Consistentie: Beursgenoteerd 0.54 vs. Privé 0.54 (d = 0.03, verwaarloosbaar)
- Sentiment: Beursgenoteerd 73.9% positief vs. Privé 74.5% positief
- Brondiversiteit: Geen significant verschil (Shannon-entropie: 1.43 vs. 1.37)
- Citatierijkdom: Privébedrijven ontvingen zelfs iets meer attributies per bedrijf (130.0 vs. 123.4)
- Financiële/regelgevende bronnen: Minder dan 1% voor beide groepen
SEC-documenten, Bloomberg-berichtgeving, Crunchbase-profielen -- niets hiervan geeft beursgenoteerde bedrijven een meetbaar voordeel in hoe AI hen waarneemt.
Wat dit voor u betekent: Als u een privébedrijf of een startup bent, heeft u geen structureel nadeel. AI behandelt een startup hetzelfde als een Fortune 500-bedrijf. Het speelveld is gelijk. De vraag is niet de grootte van uw bedrijf -- het is of uw content gestructureerd is voor AI-begrip.
De Gefundeerde Modus Uitzondering
Er is één lichtpuntje in dit alles. Wanneer AI-modellen retrieval-augmented generation gebruiken (de modus waarin ze actief het web doorzoeken voordat ze antwoorden), wordt bronattributie transparant. We testten dit met Perplexity, dat citaties op URL-niveau biedt.
In gefundeerde modus krimpt de categorie "niet-toerekenbaar" dramatisch. U kunt precies zien van welke pagina's AI putte, nauwkeurigheid verifiëren en dienovereenkomstig optimaliseren.
Wat dit voor u betekent: Naarmate meer AI-platforms retrieval-augmented modi adopteren (zoals Google's AI Overviews of Perplexity's citaties), zal het probleem van bronondoorzichtigheid afnemen. Maar voorlopig gebeuren de meeste AI-conversaties over merken in parametrische modus -- waar 70% van de kennis geen traceerbare oorsprong heeft.
Wat Te Doen Vanaf Maandag
Het onderzoek wijst op drie bruikbare prioriteiten:
1. Auditeer Uw AI-Aanwezigheid over Meerdere Modellen
Vraag niet alleen ChatGPT over uw merk. Vraag Gemini. Vraag Perplexity. Met een sentimentkloof van 0.51 punten tussen modellen en slechts 2.8% van outputs die stabiel zijn, heeft u een multi-model, herhaalde-metingen aanpak nodig om uw werkelijke AI-reputatie te begrijpen.
2. Investeer in de Bronnen die Echt Belangrijk Zijn
70% van AI-kennis zit in trainingsdata en is niet traceerbaar. Van de 30% die u kunt beïnvloeden: uw eigen websitecontent (14.7%) en tier-1 mediaberichtgeving (5.7%) zijn de top twee. Reviewplatforms zijn belangrijk voor specifieke sectoren (vooral HR Tech met 9.6%). Social media en LinkedIn samen vertegenwoordigen minder dan 1%.
Prioriteer: bedrijfseigen content eerst, verdiende media tweede, sectorspecifieke bronnen derde.
3. Bouw een Monitoringgewoonte
AI-reputatie is niet stabiel. Het verschuift met elke query, elke modelupdate, elk nieuw stuk trainingsdata. U zou uw Google-rankings niet één keer controleren en het dan vergeten. Maandelijkse AI-zichtbaarheidsmonitoring is het minimum. Driemaandelijkse uitgebreide audits over modellen zijn de standaard.
Onderzoeksdetails
- Steekproef: 24 bedrijven, 8 sectoren, 12 beursgenoteerd + 12 privé
- Prompts: 1,296 uitgevoerd, 1,311 analyseerbare antwoorden
- Modellen: GPT-5.2 (OpenAI), Gemini 3 Flash (Google), Perplexity (gefundeerde modus)
- Bronattributies: 3,041 gecodeerd door twee onafhankelijke getrainde coders
- Stabiliteitsiteraties: 5 herhalingen per prompt per merk per model
- Publicatie: Springer Discover Artificial Intelligence (peer-reviewed)
- Data-verzameling: 20 februari 2026
De Conclusie
AI bouwt een reputatie voor uw merk, of u het nu beheert of niet. De vraag is of u begrijpt waar die reputatie vandaan komt (grotendeels niet-traceerbaar), hoe stabiel het is (niet erg) en hoe verschillend het eruitziet over platforms (dramatisch verschillend).
De merken die aanbevelingsaandeel winnen in het AI-tijdperk zullen niet degenen zijn met de grootste budgetten of de langste trackrecords. Het zullen degenen zijn die begrijpen hoe AI over hen redeneert -- en hun content dienovereenkomstig structureren.
Mensen vragen ook
Lees verder
Uw AI-zichtbaarheidsrapport meet alleen ruis
Dit onderzoek bestudeert de antwoordvariatie en de consistentie van merkvermeldingen bij drie leidende Large Language Models: Google Gemini 3 Flash, OpenAI GPT-5.2 en xAI Grok-4-1. Met in totaal 239 steekproeven over drie promptvariaties (echtgenoot, echtgenote, 2025) hebben we de frequentie van merkvermeldingen, antwoordconsistentie en cross-model-overeenstemming gemeten.
Only 1 in 6 Brands Has Strong AI Visibility: Corporate Visibility Pattern Analysis
Analysis of 195 AI queries across 6 corporate brands reveals three visibility patterns: Invisible (PGE, Polpharma), Brand-Dependent (TotalEnergies, Holcim), Topic-Locked (Orlen). Only 1 in 6 has strong AI presence.
De staat van AI-zichtbaarheid: waarom merken de controle verliezen in AI-antwoorden
Zoeken bestaat nog steeds, maar beslissingen worden inmiddels elders genomen. Traditionele SEO ging ervan uit dat een goede ranking leidde tot ontdekking. AI werkt volgens andere principes. Dit artikel definieert waarom AI-zichtbaarheid belangrijk is en introduceert de vier dimensies van AI-zichtbaarheid: Aanwezigheid, Relevantie, Bruikbaarheid en Vertrouwen.
Inzicht in AI-zichtbaarheidsclassificatie: de 8 toestanden die bepalen hoe AI uw merk ziet
Zichtbaarheid in AI kent meer niveaus dan 'zichtbaar' en 'onzichtbaar': er zijn 8 specifieke toestanden (van Onzichtbaar tot Categorieleider) en elke toestand vraagt om een eigen aanpak. Dit artikel beschrijft het classificatiesysteem achter de AI Visibility Score en hoe metriekpatronen uw strategische diagnose bepalen.
De 'Best Of'-val: waarom zelfpromotende listicles verliezen op Google en winnen op ChatGPT
Drie signalen in één week: Google strafte zelfpromotende listicles af (SaaS-merken verloren 34-49% zichtbaarheid) en verlaagde crawllimieten met 86,7%, terwijl Ahrefs ontdekte dat 44% van de ChatGPT-citaties uit precies diezelfde listicles komt. Google krimpt en AI groeit. Bevat een merkaudit van 5 minuten en een gesplitste strategie voor beide ontdekkingssystemen.
Kindle: 100% van vrouw-zoekopdrachten. 0% van man-zoekopdrachten. Dezelfde AI.
Dit onderzoek breidt de analyse van de consistentie van LLM-merkaanbevelingen over verschillende prompts uit door een genderneutrale "partner"-prompt te introduceren om de effecten van genderbias te isoleren. Door vier promptvariaties te vergelijken over in totaal 299 query's leveren we overtuigend bewijs van gendergerelateerde bias in merkaanbevelingen door LLM's. Belangrijkste bevinding: Kindle verscheen in 100% van de vrouw- en partnerquery's, maar in 0% van de manquery's.
BeVisible Club
Ontvang dit soort onderzoek voordat we het publiceren.
Nieuwe onderzoeken naar AI-zichtbaarheid, rangschikkingspatronen en source-stack-gegevens worden een week voordat ze openbaar worden in uw inbox bezorgd.
Word lid van BeVisible ClubWilt u weten hoe AI uw merk ziet?
Rankfor.AI meet de AI-zichtbaarheid van uw merk op alle grote platforms en biedt praktische aanbevelingen.
Over de auteur
Oprichter
Dmitrij Żatuchin is de oprichter van Rankfor.AI. Als computerwetenschapper met een PhD in semantische webtechnologieën overbrugt hij de kloof tussen hoe AI over merken nadenkt en hoe merken begrepen willen worden. Met meer dan twintig jaar ervaring in softwarearchitectuur en academische functies aan de Estonian Business School, bouwt Dmitrij aan de meetinfrastructuur die merken nodig hebben om de overstap te maken van optimaliseren voor zoekmachines naar zichtbaar worden voor redeneermotoren.