Viktiga resultat
- 70,2% av AI:s varumärkeskunskap är ospårbar: det är den enskilt största kategorin
- GPT-5.2:s sentiment är 0,83 mot 0,32 för Gemini på samma varumärken: modellerna berättar helt olika historier
- Endast 2,8% av AI:s svar är stabila: 93,8% varierar vid upprepade prompter
- Företagsägt innehåll (14,7%) är den största identifierbara källan till AI:s varumärkeskunskap
- Börsnoterade mot privata företag: statistiskt identisk behandling av AI över alla mätetal
Ert varumärke har ett AI-rykte. Problemet: det förändras beroende på vilken AI er kund använder, när de frågar och hur de formulerar frågan. Vi genomförde den största multibranschstudien av AI-ryktes källor hittills. Här är vad varje marknadsförare behöver veta.
Varför denna studie är viktig
Varje gång en köpare frågar ChatGPT, Gemini eller Perplexity om er bransch konstruerar dessa AI-plattformar ett narrativ om ert varumärke i realtid. Det narrativet är ert AI-rykte. Till skillnad från traditionell mediebevakning kan ni inte se det, spåra dess källor eller förutsäga vad det kommer att säga härnäst.
Vi satte upp fyra frågor att besvara: Var får AI sin varumärkeskunskap? Hur konsekvent är den? Förändrar er bransch svaret? Och har börsnoterade företag en fördel?
Resultaten är obekväma för alla som tror att AI-synlighet är ett enkelt problem.
Vad vi testade
Vi studerade 24 verkliga företag inom 8 branscher: E-handel, Hälsoteknologi, Logistik, Konsulttjänster, HR-teknologi, Webbhotell, Marknadsföringsteknologi och FinTech. Hälften var börsnoterade, hälften privata. Företagen sträckte sig från Fortune 500-företag till startup-bolag.
Vi genomförde 1 296 prompter över GPT-5.2 och Gemini 3 Flash, plus 72 grundade frågor via Perplexity. Varje stabilitetsprompt upprepades fem gånger per varumärke för att mäta konsekvens. Totalt analyserade vi 1 311 svar och kodade 3 041 källhänvisningar manuellt.
Detta är inte ett blogginlägg med anekdoter. Detta är en peer-granskad studie publicerad i Springers Discover Artificial Intelligence-tidskrift.
Fynd 1: 70% av vad AI "vet" om ert varumärke kan inte spåras
Vi klassificerade varje källhänvisning AI gjorde när de diskuterade varumärken. Den enskilt största kategorin: "Övrigt / Ospårbart" med 70,2%. AI vet saker om ert varumärke, men vi kan inte exakt peka på var den informationen kom ifrån.
De källor vi kunde spåra:
| Källtyp | Andel av alla citat |
|---|---|
| Företagsägt innehåll | 14,7% |
| Tier-1 nyhetsmedia | 5,7% |
| Recensionsplattformar | 4,6% |
| Bransch-/sektorsnyheter | 1,8% |
| Wikipedia | 1,5% |
| Ekonomi-/regleringsdata | 0,6% |
| Sociala medier | 0,5% |
| 0,4% | |
| Myndighetskällor | 0,1% |
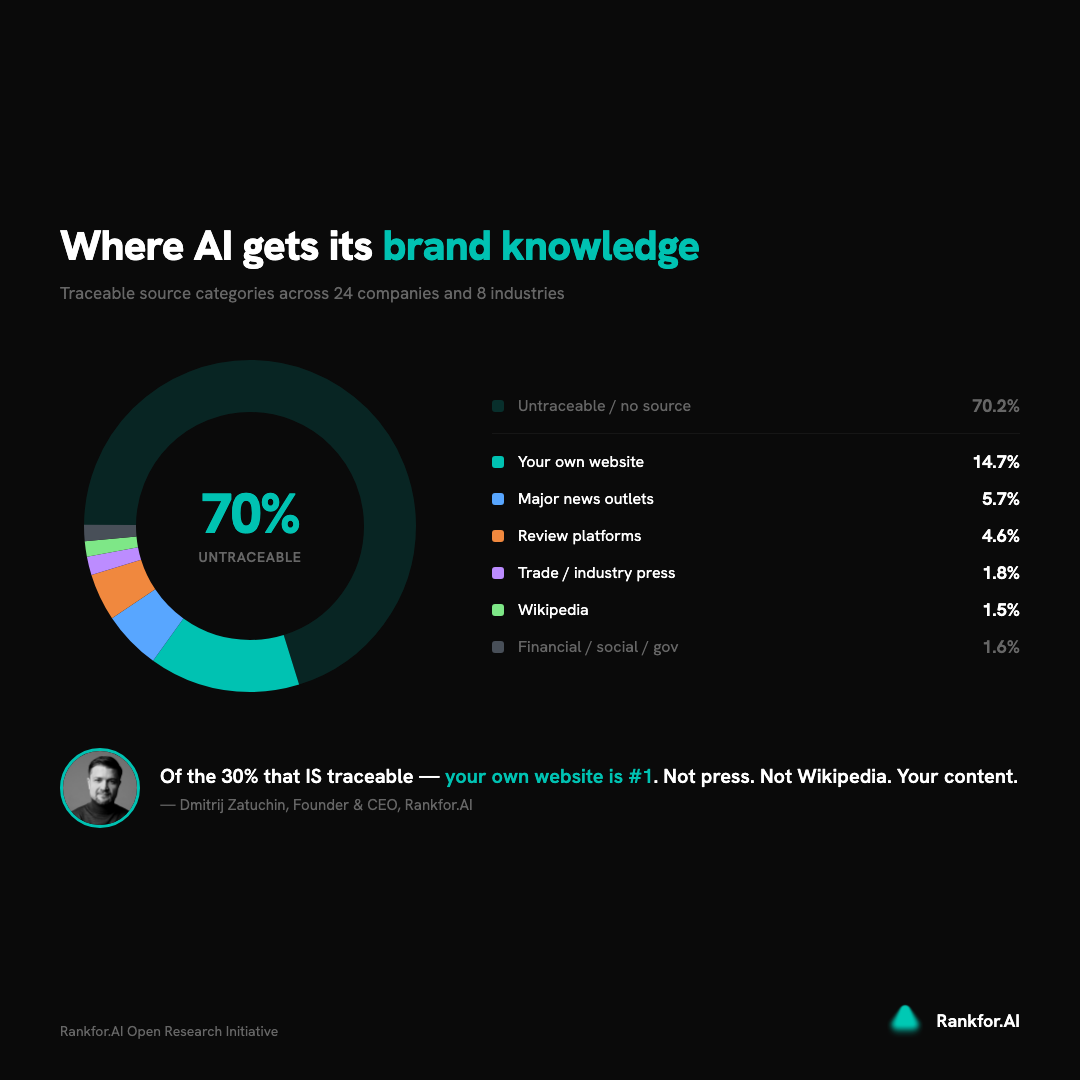
Vad detta betyder för er: Ert eget webbplatsinnehåll är den största identifierbara källan till AI:s varumärkeskunskap. Traditionell PR (tier-1 media) är tvåa. Allt annat är marginellt. Men de 70% ni inte kan påverka genom någon direkt kanal är den strukturella utmaning ingen talar om.
Fynd 2: AI-modeller berättar helt olika historier om ert varumärke
Vi jämförde hur GPT-5.2 och Gemini 3 Flash uppfattar samma varumärken. Skillnaden är dramatisk.
GPT-5.2 producerade ett genomsnittligt sentimentpoäng på 0,83 (på en skala från -1 till +1). Det är överväldigande positivt. Faktiskt var 96,4% av GPT:s svar om varumärken positiva.
Gemini 3 Flash producerade ett genomsnittligt sentiment på 0,32. Endast 51,5% av dess svar var positiva.
Korrelationen mellan de två modellernas sentimentpoäng? r = 0,37 -- svag och inte statistiskt signifikant. Modellerna använder inte bara olika skalor. De väger helt olika aspekter av rykte.
Vad detta betyder för er: Om ni endast granskar er AI-närvaro på ChatGPT ser ni en konstlat rosa bild. Era kunder använder flera AI-plattformar. Var och en berättar en annan historia om er.
Fynd 3: Fråga samma AI två gånger och ni får olika svar
Vi upprepade samma prompt fem gånger för varje varumärke på varje modell. Det genomsnittliga konsistenspoänget över alla företag: 0,54 kosinuslikhet.
För att sätta detta i perspektiv: endast 2,8% av alla företag-modell-prompt-kombinationer överskred 0,85-tröskeln vi definierade som "stabil". Samtidigt föll 93,8% under 0,70, vilket vi klassificerade som "varierande".
GPT-5.2 var något mer konsekvent (0,57) än Gemini 3 Flash (0,51), men ingen modell ger samma svar tillförlitligt.
Vad detta betyder för er: Det finns inget fast "AI-rykte". Varje gång någon frågar om ert varumärke konstruerar AI ett något annorlunda narrativ. En enprompts-granskning fångar en approximation, inte sanningen. Ni behöver upprepade mätningar för att förstå er faktiska AI-närvaro.
Fynd 4: Er bransch bestämmer vilka källor AI använder
Vi fann ett statistiskt signifikant samband mellan branschsektor och källfördelning (chi-kvadrat = 143,28, p < 0,001). Effektstorleken är liten (Cramers V = 0,08), men mönstren är verkliga och användbara.
Konsultföretag får den rikaste identifierbara källmixen: 30,8% av deras AI-rykte kommer från företagsinnehåll plus tier-1 nyheter kombinerat. McKinsey får 8% av sina spårbara citat från publikationer som Bloomberg och Financial Times.
Marknadsföringsteknologiföretag möter den högsta källopaciteten: 81,3% av deras AI-rykte är ospårbart. Om ni är inom B2B-teknik, anta att det mesta AI vet om er är inbakat i träningsdata utan tydligt ursprung.
HR-teknologivarumärken lutar sig starkt mot recensionsplattformar: 9,6% av identifierbara källor kommer från G2, Capterra och liknande webbplatser -- högst av alla sektorer.
Vad detta betyder för er: Er AI-innehållsstrategi behöver matcha källmönstren som AI faktiskt använder i er bransch. Ett konsultföretag bör investera i thought leadership och medierelationer. Ett HR-teknologiföretag bör investera i recensionsplattformsnärvaro. En generisk playbook kommer inte fungera.
Fynd 5: Att vara börsnoterat ger er ingen fördel
Vi jämförde 12 noterade företag mot 12 privata företag över varje mätetal vi mätte. Resultaten: statistiskt identiska.
- Konsekvens: Noterade 0,54 vs. Privata 0,54 (d = 0,03, försumbar)
- Sentiment: Noterade 73,9% positiva vs. Privata 74,5% positiva
- Källdiversitet: Ingen signifikant skillnad (Shannon-entropi: 1,43 vs. 1,37)
- Citationsrikedom: Privata företag fick faktiskt något fler hänvisningar per företag (130,0 vs. 123,4)
- Ekonomi-/regleringskällor: Mindre än 1% för båda grupperna
SEC-anmälningar, Bloomberg-bevakning, Crunchbase-profiler -- inget av detta ger noterade företag en mätbar fördel i hur AI uppfattar dem.
Vad detta betyder för er: Om ni är ett privat företag eller en startup är ni inte strukturellt underlägsna. AI behandlar en startup på samma sätt som ett Fortune 500-företag. Spelplanen är jämn. Frågan är inte ert företags storlek -- utan om ert innehåll är strukturerat för AI-förståelse.
Undantaget med grundat läge
Det finns en ljuspunkt i allt detta. När AI-modeller använder retrieval-augmented generation (läget där de aktivt söker på webben före svar) blir källhänvisningen transparent. Vi testade detta med Perplexity, som tillhandahåller URL-nivå citat.
I grundat läge krymper kategorin "ospårbar" dramatiskt. Ni kan se exakt vilka sidor AI hämtade från, verifiera noggrannhet och optimera därefter.
Vad detta betyder för er: När fler AI-plattformar adopterar retrieval-augmented lägen (som Googles AI Overviews eller Perplexitys citat) kommer källopacitetsproblemet att minska. Men för närvarande sker majoriteten av AI-konversationer om varumärken i parametriskt läge -- där 70% av kunskapen inte har något spårbart ursprung.
Vad ni ska göra från och med måndag
Forskningen pekar på tre användbara prioriteringar:
1. Granska er AI-närvaro över flera modeller
Fråga inte bara ChatGPT om ert varumärke. Fråga Gemini. Fråga Perplexity. Med ett 0,51-poängs sentimentgap mellan modeller och endast 2,8% av utdata som är stabila behöver ni ett multimodell-, upprepat-mätnings-tillvägagångssätt för att förstå ert faktiska AI-rykte.
2. Investera i de källor som faktiskt spelar roll
70% av AI-kunskap är inbakad i träningsdata och ospårbar. Av de 30% ni kan påverka: ert eget webbplatsinnehåll (14,7%) och tier-1 mediebevakning (5,7%) är de två viktigaste. Recensionsplattformar spelar roll för specifika branscher (särskilt HR-teknologi med 9,6%). Sociala medier och LinkedIn tillsammans står för mindre än 1%.
Prioritera: företagsägt innehåll först, earned media andra, branschspecifika källor tredje.
3. Bygg en övervakningsvana
AI-rykte är inte stabilt. Det skiftar med varje fråga, varje modelluppdatering, varje ny bit träningsdata. Ni skulle inte kontrollera era Google-rankningar en gång och glömma det. Månatlig AI-synlighetsövervakning är minimum. Kvartalsvisa omfattande granskningar över modeller är standarden.
Studiedetaljer
- Urval: 24 företag, 8 branscher, 12 börsnoterade + 12 privata
- Prompter: 1 296 administrerade, 1 311 analyserbara svar
- Modeller: GPT-5.2 (OpenAI), Gemini 3 Flash (Google), Perplexity (grundat läge)
- Källhänvisningar: 3 041 kodade av två oberoende tränade kodare
- Stabilitetsiterationer: 5 upprepningar per prompt per varumärke per modell
- Publikation: Springer Discover Artificial Intelligence (peer-granskad)
- Datainsamling: 20 februari 2026
Slutsatsen
AI bygger ett rykte för ert varumärke oavsett om ni hanterar det eller inte. Frågan är om ni förstår var det ryktet kommer ifrån (mestadels ospårbart), hur stabilt det är (inte särskilt), och hur annorlunda det ser ut över plattformar (dramatiskt annorlunda).
De varumärken som vinner rekommendationsandel i AI-eran kommer inte vara de med störst budgetar eller längst meritlista. De kommer vara de som förstår hur AI resonerar om dem -- och strukturerar sitt innehåll därefter.
Andra frågar även
Läs också
Din AI-synlighetsrapport mäter brus
Denna studie undersöker svarsvariation och konsistens i varumärkesomnämnanden hos tre ledande LLM-modeller: Google Gemini 3 Flash, OpenAI GPT-5.2 och xAI Grok-4-1. Med totalt 239 urval över tre promptvariationer (make, hustru, 2025) mätte vi varumärkesomnämningsfrekvens, svarskonsistens och överensstämmelse mellan modellerna.
Only 1 in 6 Brands Has Strong AI Visibility: Corporate Visibility Pattern Analysis
Analysis of 195 AI queries across 6 corporate brands reveals three visibility patterns: Invisible (PGE, Polpharma), Brand-Dependent (TotalEnergies, Holcim), Topic-Locked (Orlen). Only 1 in 6 has strong AI presence.
AI-synlighetens tillstånd: varför varumärken förlorar kontrollen i AI-svar
Sökningen finns kvar, men besluten fattas numera någon annanstans. Traditionell SEO antog att om du rankade bra skulle du bli upptäckt. AI fungerar inte så. Denna artikel förklarar varför AI-synlighet är viktig och introducerar de fyra dimensionerna av AI-synlighet: Närvaro, Relevans, Användbarhet och Förtroende.
Förstå AI-synlighetsklassificering: de 8 tillstånd som definierar hur AI ser ditt varumärke
AI ser ditt varumärke på mer komplexa sätt än att enbart betrakta det som synligt eller osynligt. Det finns 8 distinkta tillstånd (från Osynlig till Kategoriledare) och varje tillstånd kräver en specifik strategi. Denna artikel förklarar klassificeringssystemet bakom AI Visibility Score och hur mättalsmönster avgör din strategiska diagnos.
"Bäst av"-fällan: varför självreklamerande listartiklar förlorar i Google och vinner i ChatGPT
Tre signaler på en vecka: Google straffade självreklamerande listartiklar (SaaS-varumärken förlorar 34-49% i synlighet) och sänkte sin crawl-gräns med 86,7%, samtidigt som Ahrefs fann att 44% av alla ChatGPT-citeringar kommer från just dessa listartiklar. Google krymper, AI växer. Innehåller en 5-minuters varumärkesgranskning och en delad strategi för att navigera i båda upptäcktssystemen.
Kindle: 100 % av frågorna om hustru. 0 % av frågorna om make. Samma AI.
Denna studie utökar analysen av varumärkeskonsistens i stora språkmodeller (LLM) över flera promptar genom att introducera en könsneutral "partner"-prompt för att isolera effekterna av könsfördomar. Genom att jämföra fyra promptvariationer över totalt 299 stickprov ger vi starka bevis på könsbaserade fördomar i varumärkesrekommendationer från stora språkmodeller. Viktigt resultat: Kindle dök upp i 100 % av upprepningarna för både hustru och partner, men i 0 % av upprepningarna för make.
BeVisible Club
Få forskning som denna innan den publiceras.
Nya studier om AI-synlighet, rankningsmönster och källstacksdata levererade till din inkorg en vecka innan de blir offentliga.
Gå med i BeVisible ClubVill du veta hur AI ser på ditt varumärke?
Rankfor.AI mäter ditt varumärkes AI-synlighet på alla stora plattformar och ger konkreta rekommendationer.
Om författaren
Grundare
Dmitrij Żatuchin är grundare av Rankfor.AI. Som datavetare med en doktorsexamen inom semantiska webbteknologier överbryggar han klyftan mellan hur AI resonerar kring varumärken och hur varumärken vill bli förstådda. Med över två decennier av erfarenhet inom programvaruarkitektur och akademiska roller vid Estonian Business School bygger Dmitrij den mätinfrastruktur varumärken behöver för att gå från att optimera för sökmotorer till att bli synliga i slutledningsmotorer.